Október 20-án egy komoly leállás borzolta a Revolut felhasználók kedélyeit: sokan órákon keresztül nem tudtak fizetni, készpénzt felvenni, vagy egyáltalán belépni az alkalmazásba, hogy ellenőrizzék az egyenlegüket. A Revolut most egy részletes, technikai blogposztban tárta a nyilvánosság elé, hogy pontosan mi is történt a háttérben, miért vett igénybe a vártnál több időt a javítás, és milyen lépéseket tettek a probléma végleges orvoslására.
Az alapvető ok: Áramellátási probléma a Google Cloudnál
Október 20-án reggel 8:00 óra környékén (06:00 UTC) áramszünet lépett fel a Google Cloud londoni régiójának egyik adatközpontjában (a „B” zónában), amelyet a Revolut is használ a rendszerei futtatására.
A Revolut kiemelte: bár az applikáció nem volt elérhető, az ügyfelek pénze és személyes adatai egyetlen másodpercig sem voltak veszélyben.
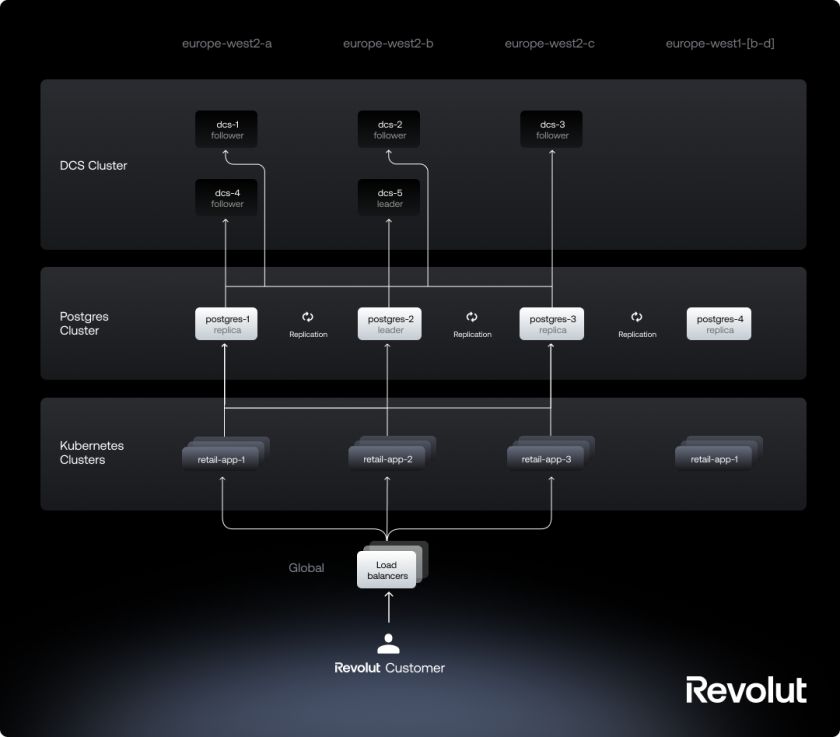
A fintech cég infrastruktúráját úgy tervezték, hogy egy ilyen lokális áramszünet észrevétlen maradjon a felhasználók számára. A londoni régióban az adataikat három különálló adatközponti zónában (A, B és C) osztják el. Ha az egyik zóna kiesik, a rendszernek egy automatikus biztonsági mechanizmus (úgynevezett failover) révén azonnal át kellene kapcsolnia egy másik, hibátlanul működő zónára. Ez a biztonsági mechanizmus azonban ezúttal kudarcot vallott.

Miért nem működött a biztonsági átkapcsolás?
Hogy megértsük a hibát, érdemes röviden megnézni, hogyan működik a háttérrendszer. A Revolut „koordinációs szervereket” használ, amelyek egyfajta döntőbizottságként működnek: ők határozzák meg, hogy egy meghibásodás esetén melyik tartalék adatbázis vegye át az elsődleges szerepet.
Ezek a szerverek ötös csoportokban dolgoznak, és a döntéshozatalhoz a többség – azaz minimum három szerver – egyetértésére (kvórumra) van szükség.
A hiba láncreakciója a következőképpen nézett ki:
-
Még az áramszünet előtt, néhány csoportban egy-egy szerver már offline állapotban volt egy korábbi, sikertelen rutinfrissítés miatt. Mivel azonban 4 szerver még mindig működött, ez nem okozott fennakadást, a rendszer pedig sajnos nem riasztotta a mérnököket a hiányzó gép miatt.
-
Amikor a „B” zónában elment az áram, ebből az ötfős csoportból további két szerver vált elérhetetlenné.
-
A matek innentől egyszerű: az ötből már csak két szerver maradt online. Mivel a döntéshez három szavazat (kvórum) kell, a rendszer „lefagyott”. Nem tudta eldönteni, hogy melyik adatbázist léptesse elő elsődlegesnek, így a biztonsági átkapcsolás (failover) egyszerűen nem történt meg.
Miért tartott ilyen sokáig a helyreállítás?
Maga az áramszünet kora reggel történt, a szolgáltatások egy része azonban csak késő délutánra állt helyre. Ennek három fő oka volt:
-
Vakrepülés a diagnosztikában: A mérnökök által használt grafikus, belső monitorozó eszközök pont az érintett „B” zónában futottak. Ezek hiányában a szakembereknek parancssorok és nyers naplófájlok (logok) silabizálásával kellett diagnosztizálniuk a hibát, és sebtében kellett felépíteniük új mérőeszközöket a működő zónákban, ami rengeteg időt emésztett fel.
-
Téves kezdeti információk: A korai jelentések arról szóltak, hogy több felhőrégió is érintett lehet a leállásban. Időbe telt biztosan kizárni, hogy a hiba nem terjedt át az „A” és „C” zónákra.
-
Adatbázis szinkronizációs akadályok: Miután sikerült helyreállítani a döntéshozó szerverek számát, kiderült, hogy néhány adatbázis egy apró késleltetés miatt nem volt tökéletesen szinkronban, így azok biztonsági okokból „csak olvasható” módban maradtak. A mérnököknek manuálisan kellett megkeresniük a biztonságos helyreállítási útvonalat.
A leállás kronológiája (magyar idő szerint)
-
08:00: Áramszünet a londoni „B” zónában. (A háttérben futó offline tartalékrendszereknek köszönhetően a kártyás tranzakciók egy része szerencsére ekkor is átment).
-
14:40: A kártyás engedélyezések és a bolti fizetések újra zavartalanul működnek.
-
17:45: Az ügyfelek újra be tudnak lépni az appba, frissülnek az egyenlegek és elindulnak az átutalások.
-
19:15: Minden fennmaradó szolgáltatás 100%-osan helyreállt.
Mit tesz a Revolut a jövőben?
A cég elismerte, hogy szolgáltatásaikkal kapcsolatban a 24/7-es, kivétel nélküli rendelkezésre állás az elvárás, aminek ezúttal nem feleltek meg. A probléma elhárításán túl azonnal nekiláttak a rendszerszintű javításoknak:
-
Proaktív riasztások: Továbbfejlesztették a monitorozó rendszert. Ha egy ötfős szervercsoportból akár csak egy is kiesik, a rendszer mostantól azonnal, proaktív riasztást küld, hogy a mérnökök pótolhassák azt, még egy esetleges áramszünet előtt.
-
Független diagnosztikai eszközök: A háttéreszközöket és monitorozó felületeket úgy osztják el a zónák között, hogy egy adatközpont kiesése esetén is zökkenőmentesen tudják folytatni a hibakeresést.
-
Kibővített tesztelés: A katasztrófa-helyreállítási gyakorlatokat kiterjesztik pontosan a most megismert körülményekre is, ráadásul ezentúl gyakrabban tesztelik a rendszert extrém terhelés alatt.
-
Kiegyensúlyozott szerverelosztás: Megváltoztatják a biztonsági szerverek felhőzónák közötti elosztásának logikáját, elkerülve azt, hogy bármelyik zóna aránytalanul fontos szerepet kapjon a hibatűrésben.
A Revolut hónapok óta készült hogy elkerülje története legnagyobb leállását
Bár a kiváltó ok egy külső partner, a Google Cloud infrastruktúrájának hibája volt, a Revolut magára vállalta a felelősséget azért, hogy a saját védőhálójuk átszakadt. A bevezetett szigorítások és a most megosztott, rendkívül transzparens tájékoztatás egyértelműen azt szolgálják, hogy a jövőben egy lokális áramszünet tényleg csak egy észrevétlen, másodperc-töredéknyi átkapcsolást jelentsen a felhasználóknak.